Domain forschungsgeschichte.de kaufen?
Wir ziehen mit dem Projekt
forschungsgeschichte.de um.
Sind Sie am Kauf der Domain
forschungsgeschichte.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain forschungsgeschichte.de kaufen?
Wie kann man Daten beim Web Scraping in Python effektiv speichern?
Um Daten beim Web Scraping in Python effektiv zu speichern, gibt es mehrere Möglichkeiten. Eine Möglichkeit ist die Verwendung von CSV-Dateien, die einfach zu erstellen und zu lesen sind. Eine andere Möglichkeit ist die Verwendung von Datenbanken wie SQLite oder MySQL, um die Daten strukturiert zu speichern und effizient darauf zuzugreifen. Eine weitere Option ist die Verwendung von JSON-Dateien, um die Daten im JSON-Format zu speichern, was besonders nützlich ist, wenn die Daten für den Austausch mit anderen Systemen verwendet werden sollen. **
Wie formuliert man eine spezifische Hypothese zum Thema Web Scraping in der Informatik?
Eine spezifische Hypothese zum Thema Web Scraping in der Informatik könnte lauten: "Die Verwendung von Web Scraping-Techniken zur automatischen Extraktion von Daten von Websites führt zu einer effizienteren Datenerfassung im Vergleich zur manuellen Erfassung." Diese Hypothese könnte dann durch Experimente oder Fallstudien überprüft werden, um festzustellen, ob die Verwendung von Web Scraping tatsächlich zu einer verbesserten Effizienz bei der Datenerfassung führt. **


Ähnliche Suchbegriffe für Web-Scraping-with-Python
Top-Angebote
Produkte zum Begriff Web-Scraping-with-Python:
-
F-Line Dishwashing brush with scraping edge and nylon bristlesDishwashing brush with scraping edge and stiff nylon bristles. Plastic handle in several colors. With scraper on the dishwashing head, for scraping dirt and stuck-on residue from plates and pans.4,03 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Sweigart, Al: Cracking Codes with PythonCracking Codes with Python , An Introduction to Building and Breaking Ciphers , > , Erscheinungsjahr: 20180123, Produktform: Kartoniert, Autoren: Sweigart, Al, Seitenzahl/Blattzahl: 416, Themenüberschrift: COMPUTERS / Programming Languages / Python, Keyword: Python;ciphers;codes;computers;computer;coding;security;code;cryptography;technology;hacking;coding for kids;privacy;hackers;crypto;algorithm;computer programming;python;python programming;clean code;algorithms;python for data analysis;python machine learning;cybersecurity;tech;learning python;cyber security;python for beginners;python data science;coding for beginners;python 3;penetration testing;network security;computer books;cyber security books;hacking books;computer security, Fachschema: Programmiersprachen~Kryptografie~Verschlüsselung~Datenverarbeitung / Datenverschlüsselung, Kryptografie~Kryptologie, Fachkategorie: Kryptografie, Verschlüsselungstechnologie~Kodierungstheorie und Verschlüsselung (Kryptologie), Altersempfehlung / Lesealter: 18, ab Alter: 12, Imprint-Titels: No Starch Press, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Random House LLC US, Verlag: Random House LLC US, Länge: 233, Breite: 179, Höhe: 25, Gewicht: 794, Produktform: Kartoniert, Genre: Importe, Genre: Importe,31,82 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
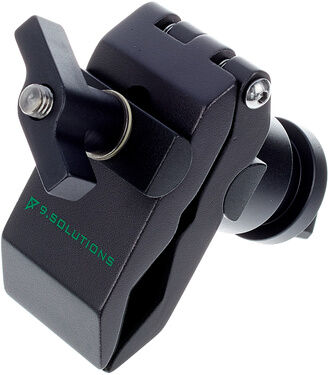
9.solutions Python clamp with grip joint9.solutions 9.VP5081C Python clamp with grip jont, Aufnahmegröße: 0 - 50 mm, Max. Tragfähigkeit: 20 kg, Befestigungsarten: 1x 5/8" (16 mm) Durchgangsaufnahme, 1x 3/8" (10 mm) Durchgangsaufnahme, Gewicht: 455 g29,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
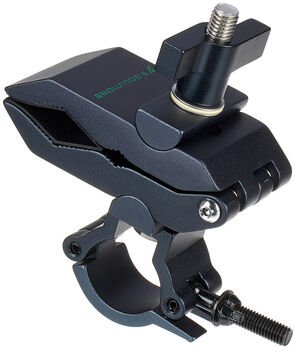
9.solutions Python with 35mm Tube Mount9.solutions Python with 35mm Tube Mount, Python Klemme mit montiertem 35 mm coupler, Klemmbereich: 0 - 50 mm, Max. Tragfähigkeit: 20 kg, Coupler für 35 mm Rundrohre, passend in Verbindung mit Ex-Sus Pole25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Warum funktioniert der Web-Scraping-Code nicht?
Es gibt verschiedene Gründe, warum der Web-Scraping-Code möglicherweise nicht funktioniert. Einer der häufigsten Gründe ist, dass sich die Struktur oder das Layout der Webseite geändert hat, auf die zugegriffen wird, was dazu führt, dass der Code nicht mehr die erwarteten Elemente findet. Ein weiterer möglicher Grund ist, dass die Webseite möglicherweise eine Anti-Scraping-Maßnahme implementiert hat, die den Zugriff auf den Inhalt blockiert. Es ist auch möglich, dass es einen Fehler im Code selbst gibt, wie zum Beispiel eine falsche Syntax oder einen Fehler bei der Verwendung von Bibliotheken oder Modulen. **
-
Wie kann ich WhatsApp-Einladungslinks vor Web-Scraping schützen?
Um WhatsApp-Einladungslinks vor Web-Scraping zu schützen, könntest du verschiedene Maßnahmen ergreifen. Eine Möglichkeit besteht darin, die Einladungslinks mit einem Captcha zu schützen, um sicherzustellen, dass nur echte Benutzer darauf zugreifen können. Eine weitere Möglichkeit besteht darin, die Einladungslinks regelmäßig zu ändern, um zu verhindern, dass sie von Bots erfasst werden. Darüber hinaus könntest du auch die Zugriffsrechte für deine WhatsApp-Gruppen einschränken, um sicherzustellen, dass nur autorisierte Benutzer beitreten können. **
-
Was sind die möglichen rechtlichen Konsequenzen beim Web-Scraping von öffentlich verfügbaren Daten?
Die rechtlichen Konsequenzen beim Web-Scraping von öffentlich verfügbaren Daten können je nach Land und Gesetzgebung variieren. In einigen Ländern kann das Scraping von Daten ohne Zustimmung des Website-Betreibers als Verstoß gegen das Urheberrecht oder als Verletzung der Nutzungsbedingungen angesehen werden. Dies kann zu rechtlichen Schritten wie Abmahnungen oder Schadensersatzforderungen führen. **
-
Was sind die rechtlichen und ethischen Aspekte von Web-Scraping?
Rechtlich gesehen kann Web-Scraping gegen die Nutzungsbedingungen einer Website verstoßen und als Verletzung des Urheberrechts angesehen werden. Es ist wichtig, die Datenschutzgesetze zu beachten und sicherzustellen, dass keine persönlichen Daten ohne Zustimmung gesammelt werden. Ethisch gesehen sollte Web-Scraping transparent und fair erfolgen, um die Privatsphäre und die Rechte der Website-Betreiber zu respektieren. **

Welche rechtlichen und ethischen Aspekte sollten bei der Durchführung von Web-Scraping beachtet werden? Was sind die potenziellen Vorteile und Risiken von Web-Scraping für Unternehmen?
Rechtlich sollten Unternehmen sicherstellen, dass sie nur öffentlich zugängliche Daten sammeln und keine Urheberrechte verletzen. Ethisch gesehen sollten sie die Privatsphäre der Nutzer respektieren und transparent über ihre Datenerfassungspraktiken informieren. Potenzielle Vorteile von Web-Scraping für Unternehmen sind die Möglichkeit, wertvolle Informationen über Wettbewerber, Kundenverhalten und Markttrends zu gewinnen. Risiken umfassen rechtliche Konsequenzen bei Verletzung von Urheberrechten oder Datenschutzbestimmungen sowie den Verlust von Vertrauen bei Kunden, wenn sie sich in ihren Datenschutzrechten verletzt fühlen. **
Wie kann man Beautiful Soup oder SeleniumScrapy zum Web Scraping verwenden?
Beautiful Soup und SeleniumScrapy sind Python-Bibliotheken, die zum Web Scraping verwendet werden können. Mit Beautiful Soup kann man HTML- oder XML-Dokumente analysieren und daraus Daten extrahieren. SeleniumScrapy hingegen ermöglicht das automatisierte Durchsuchen von Webseiten, das Klicken auf Links und das Ausfüllen von Formularen. Beide Bibliotheken bieten eine Vielzahl von Funktionen und Methoden, um das Web Scraping effizient und einfach durchzuführen. **
Top-Angebote
Produkte zum Begriff Web-Scraping-with-Python:
-
Web Scraping with Python 3e, Fachbücher von Ryan MitchellDas Buch "Web Scraping with Python 3e" von Ryan Mitchell bietet eine umfassende Einführung in die Techniken und Tools des Web Scraping unter Verwendung der Programmiersprache Python. Diese überarbeitete Auflage behandelt die neuesten Entwicklungen und Best Practices in diesem sich schnell entwickelnden Bereich. Leserinnen und Leser erhalten wertvolle Einblicke in die Erstellung von Web-Scraping-Anwendungen, die Datenextraktion aus verschiedenen Online-Quellen und die Verarbeitung dieser Daten für unterschiedliche Anwendungen. Das Buch richtet sich an Technik- und IT-Interessierte, die ihre Fähigkeiten im Umgang mit Python erweitern möchten, um Daten effizient zu sammeln und zu analysieren. Die klare Struktur und die praxisnahen Beispiele machen es zu einem nützlichen Leitfaden für Anfänger und Fortgeschrittene gleichermassen.54,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
F-Line Dishwashing brush with scraping edge and nylon bristlesDishwashing brush with scraping edge and stiff nylon bristles. Plastic handle in several colors. With scraper on the dishwashing head, for scraping dirt and stuck-on residue from plates and pans.4,03 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Sweigart, Al: Cracking Codes with PythonCracking Codes with Python , An Introduction to Building and Breaking Ciphers , > , Erscheinungsjahr: 20180123, Produktform: Kartoniert, Autoren: Sweigart, Al, Seitenzahl/Blattzahl: 416, Themenüberschrift: COMPUTERS / Programming Languages / Python, Keyword: Python;ciphers;codes;computers;computer;coding;security;code;cryptography;technology;hacking;coding for kids;privacy;hackers;crypto;algorithm;computer programming;python;python programming;clean code;algorithms;python for data analysis;python machine learning;cybersecurity;tech;learning python;cyber security;python for beginners;python data science;coding for beginners;python 3;penetration testing;network security;computer books;cyber security books;hacking books;computer security, Fachschema: Programmiersprachen~Kryptografie~Verschlüsselung~Datenverarbeitung / Datenverschlüsselung, Kryptografie~Kryptologie, Fachkategorie: Kryptografie, Verschlüsselungstechnologie~Kodierungstheorie und Verschlüsselung (Kryptologie), Altersempfehlung / Lesealter: 18, ab Alter: 12, Imprint-Titels: No Starch Press, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Random House LLC US, Verlag: Random House LLC US, Länge: 233, Breite: 179, Höhe: 25, Gewicht: 794, Produktform: Kartoniert, Genre: Importe, Genre: Importe,31,82 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann man Daten beim Web Scraping in Python effektiv speichern?
Um Daten beim Web Scraping in Python effektiv zu speichern, gibt es mehrere Möglichkeiten. Eine Möglichkeit ist die Verwendung von CSV-Dateien, die einfach zu erstellen und zu lesen sind. Eine andere Möglichkeit ist die Verwendung von Datenbanken wie SQLite oder MySQL, um die Daten strukturiert zu speichern und effizient darauf zuzugreifen. Eine weitere Option ist die Verwendung von JSON-Dateien, um die Daten im JSON-Format zu speichern, was besonders nützlich ist, wenn die Daten für den Austausch mit anderen Systemen verwendet werden sollen. **
-
Wie formuliert man eine spezifische Hypothese zum Thema Web Scraping in der Informatik?
Eine spezifische Hypothese zum Thema Web Scraping in der Informatik könnte lauten: "Die Verwendung von Web Scraping-Techniken zur automatischen Extraktion von Daten von Websites führt zu einer effizienteren Datenerfassung im Vergleich zur manuellen Erfassung." Diese Hypothese könnte dann durch Experimente oder Fallstudien überprüft werden, um festzustellen, ob die Verwendung von Web Scraping tatsächlich zu einer verbesserten Effizienz bei der Datenerfassung führt. **
-
Warum funktioniert der Web-Scraping-Code nicht?
Es gibt verschiedene Gründe, warum der Web-Scraping-Code möglicherweise nicht funktioniert. Einer der häufigsten Gründe ist, dass sich die Struktur oder das Layout der Webseite geändert hat, auf die zugegriffen wird, was dazu führt, dass der Code nicht mehr die erwarteten Elemente findet. Ein weiterer möglicher Grund ist, dass die Webseite möglicherweise eine Anti-Scraping-Maßnahme implementiert hat, die den Zugriff auf den Inhalt blockiert. Es ist auch möglich, dass es einen Fehler im Code selbst gibt, wie zum Beispiel eine falsche Syntax oder einen Fehler bei der Verwendung von Bibliotheken oder Modulen. **
-
Wie kann ich WhatsApp-Einladungslinks vor Web-Scraping schützen?
Um WhatsApp-Einladungslinks vor Web-Scraping zu schützen, könntest du verschiedene Maßnahmen ergreifen. Eine Möglichkeit besteht darin, die Einladungslinks mit einem Captcha zu schützen, um sicherzustellen, dass nur echte Benutzer darauf zugreifen können. Eine weitere Möglichkeit besteht darin, die Einladungslinks regelmäßig zu ändern, um zu verhindern, dass sie von Bots erfasst werden. Darüber hinaus könntest du auch die Zugriffsrechte für deine WhatsApp-Gruppen einschränken, um sicherzustellen, dass nur autorisierte Benutzer beitreten können. **
Ähnliche Suchbegriffe für Web-Scraping-with-Python
-
9.solutions Python clamp with grip joint9.solutions 9.VP5081C Python clamp with grip jont, Aufnahmegröße: 0 - 50 mm, Max. Tragfähigkeit: 20 kg, Befestigungsarten: 1x 5/8" (16 mm) Durchgangsaufnahme, 1x 3/8" (10 mm) Durchgangsaufnahme, Gewicht: 455 g29,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
9.solutions Python with 35mm Tube Mount9.solutions Python with 35mm Tube Mount, Python Klemme mit montiertem 35 mm coupler, Klemmbereich: 0 - 50 mm, Max. Tragfähigkeit: 20 kg, Coupler für 35 mm Rundrohre, passend in Verbindung mit Ex-Sus Pole25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Goldene Daten: Wie Web Scraping die Bewertung von Kunden verändert, Taschenbuch von Gilberto Romer Apaza Ramos,Edinson Manuel Ñamo Alayo, Verlag UnserGoldene Daten: Wie Web Scraping Die Bewertung Von Kunden Verändert, Taschenbuch Von Gilberto Romer Apaza Ramos,edinson Manuel Ñamo Alayo, Verlag Unser Wissen, 978-620-7-89445-1, Seitenanzahl: 10068,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
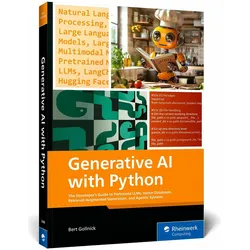
Generative AI with Python, Fachbücher von Bert, GollnickDas Buch "Generative AI with Python" vom Rheinwerk Verlag bietet eine umfassende Einführung in die Welt der generativen Künstlichen Intelligenz. Es richtet sich an Fachleute und Interessierte im Bereich Technik und IT, die sich mit modernen Technologien wie vortrainierten grossen Sprachmodellen, Vektordatenbanken und retrieval-augmented generation auseinandersetzen möchten. Der Autor Gollnick vermittelt in diesem Fachbuch praxisnahe Kenntnisse und Techniken, die für die Entwicklung und Implementierung von KI-Anwendungen unerlässlich sind. Mit 392 Seiten bietet das Taschenbuch eine detaillierte Analyse und zahlreiche Beispiele, die es den Leserinnen und Lesern ermöglichen, ein tiefes Verständnis für die Funktionsweise und die Anwendungsmöglichkeiten von generativer KI zu entwickeln. Die erste Auflage, veröffentlicht im Jahr 2025, ist in englischer Sprache verfasst und richtet sich an ein internationales Publikum. Dieses Sachbuch ist ein wertvolles Nachschlagewerk für alle, die sich mit den neuesten Entwicklungen in der KI-Technologie beschäftigen möchten.59,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die möglichen rechtlichen Konsequenzen beim Web-Scraping von öffentlich verfügbaren Daten?
Die rechtlichen Konsequenzen beim Web-Scraping von öffentlich verfügbaren Daten können je nach Land und Gesetzgebung variieren. In einigen Ländern kann das Scraping von Daten ohne Zustimmung des Website-Betreibers als Verstoß gegen das Urheberrecht oder als Verletzung der Nutzungsbedingungen angesehen werden. Dies kann zu rechtlichen Schritten wie Abmahnungen oder Schadensersatzforderungen führen. **
-
Was sind die rechtlichen und ethischen Aspekte von Web-Scraping?
Rechtlich gesehen kann Web-Scraping gegen die Nutzungsbedingungen einer Website verstoßen und als Verletzung des Urheberrechts angesehen werden. Es ist wichtig, die Datenschutzgesetze zu beachten und sicherzustellen, dass keine persönlichen Daten ohne Zustimmung gesammelt werden. Ethisch gesehen sollte Web-Scraping transparent und fair erfolgen, um die Privatsphäre und die Rechte der Website-Betreiber zu respektieren. **
-
Welche rechtlichen und ethischen Aspekte sollten bei der Durchführung von Web-Scraping beachtet werden? Was sind die potenziellen Vorteile und Risiken von Web-Scraping für Unternehmen?
Rechtlich sollten Unternehmen sicherstellen, dass sie nur öffentlich zugängliche Daten sammeln und keine Urheberrechte verletzen. Ethisch gesehen sollten sie die Privatsphäre der Nutzer respektieren und transparent über ihre Datenerfassungspraktiken informieren. Potenzielle Vorteile von Web-Scraping für Unternehmen sind die Möglichkeit, wertvolle Informationen über Wettbewerber, Kundenverhalten und Markttrends zu gewinnen. Risiken umfassen rechtliche Konsequenzen bei Verletzung von Urheberrechten oder Datenschutzbestimmungen sowie den Verlust von Vertrauen bei Kunden, wenn sie sich in ihren Datenschutzrechten verletzt fühlen. **
-
Wie kann man Beautiful Soup oder SeleniumScrapy zum Web Scraping verwenden?
Beautiful Soup und SeleniumScrapy sind Python-Bibliotheken, die zum Web Scraping verwendet werden können. Mit Beautiful Soup kann man HTML- oder XML-Dokumente analysieren und daraus Daten extrahieren. SeleniumScrapy hingegen ermöglicht das automatisierte Durchsuchen von Webseiten, das Klicken auf Links und das Ausfüllen von Formularen. Beide Bibliotheken bieten eine Vielzahl von Funktionen und Methoden, um das Web Scraping effizient und einfach durchzuführen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.